Алгоритмы и сложность
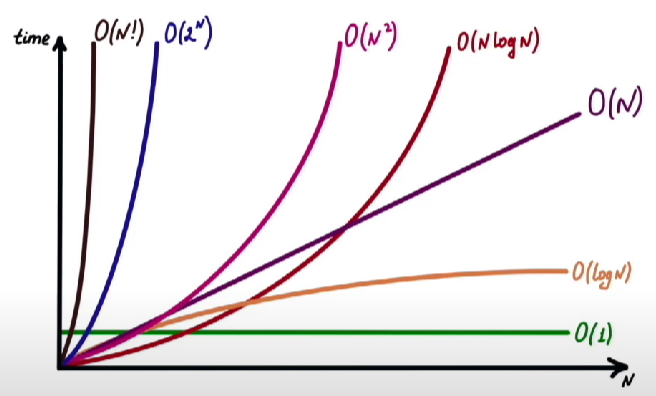
Алгоритмическая сложность оценивает, как растёт потребление ресурсов при увеличении входных данных. Она важна и на собеседовании, и в коде приложения, который ищет, сортирует, группирует или отображает растущие коллекции.
Big O
Big O описывает асимптотическую верхнюю границу роста времени или памяти. Это не прогноз в миллисекундах. Константы и слагаемые меньшего порядка отбрасываются, поэтому O(2n + 10) упрощается до O(n).
Всегда уточняйте, что означает n и какой случай рассматривается:
- Худший случай задаёт предел для любого допустимого ввода размера
n. - Средний случай зависит от предположений о распределении входных данных.
- Амортизированная стоимость распределяет редкие дорогие операции по последовательности, например расширение
ArrayList.
Временная сложность и сложность по дополнительной памяти оцениваются отдельно. Алгоритм может ускорить работу, построив дополнительный set или map.
Распространённые порядки роста
O(1): постоянный объём работы, например доступ к массиву по индексу.O(log n): оставшаяся задача уменьшается в постоянное число раз, как в бинарном поиске.O(n): один полный проход поnэлементам.O(n log n): типичная сложность эффективной сортировки сравнениями.O(n²): обработка множества пар, например простой двойной цикл сравнений.O(2ⁿ)илиO(n!): полный перебор комбинаций или перестановок; без отсечения подходит только для малых данных.
Считайте общий объём работы, а не только циклы. Два последовательных цикла O(n) дают O(n), а не O(n²). Вложенные циклы могут иметь O(n²), O(n log n) или O(n × m) в зависимости от границ. Цикл, который постоянно делит диапазон пополам, имеет O(log n).
Поиск
Линейный поиск в неотсортированном списке имеет O(n). Бинарный поиск имеет O(log n), но требует данных, отсортированных в том же порядке, который используется при поиске.
Бинарный поиск эффективен для массивов и списков с произвольным доступом, потому что чтение среднего элемента стоит O(1). В связном списке поиск каждой средней позиции требует прохода, поэтому практическое преимущество исчезает.
Однократная сортировка стоит примерно O(n log n). Она может окупиться перед множеством поисков, но не обязательно перед одним. Если нужны частые проверки наличия без сохранения порядка, построение HashSet за O(n) обычно даёт ожидаемый поиск O(1).
Сортировки
| Алгоритм | Лучший | Средний | Худший | Дополнительная память | Практическая заметка |
|---|---|---|---|---|---|
| Bubble sort | O(n) с ранним выходом |
O(n²) |
O(n²) |
O(1) |
Учебный алгоритм, редко уместный в рабочем коде. |
| Insertion sort | O(n) |
O(n²) |
O(n²) |
O(1) |
Используется внутри гибридных сортировок для малых или почти отсортированных диапазонов. |
| Merge sort | O(n log n) |
O(n log n) |
O(n log n) |
Обычно O(n) |
Предсказуем и стабилен в распространённых реализациях. |
| Quicksort | O(n log n) |
O(n log n) |
O(n²) |
O(log n) в среднем, O(n) в худшем случае для стека |
Быстрое разделение на месте; результат зависит от pivot и реализации. |
Рабочие функции сортировки обычно используют оптимизированные или гибридные реализации. Предпочитайте стандартную библиотеку, если сам алгоритм не является задачей. Проверяйте гарантии API, когда важны стабильность, память или худший случай.
Стоимость операций коллекций
Таблица описывает распространённые JVM-реализации и типичную стоимость, а не любой возможный List или Map.
| Структура | Чтение / поиск | Вставка | Удаление | Практическая заметка |
|---|---|---|---|---|
ArrayList |
O(1) по индексу; O(n) по значению |
Амортизированное O(1) в конец; O(n) в середину |
O(n) из середины |
Хороший выбор по умолчанию для последовательных данных и перебора. |
LinkedList |
O(n) по индексу или значению |
O(1) в известном узле или на конце; иначе поиск O(n) |
Аналогично: обычно доминирует поиск | Java API не раскрывает узлы; плохая локальность часто перевешивает теоретические преимущества. |
ArrayDeque |
O(1) с обоих концов |
Амортизированное O(1) с обоих концов |
O(1) с обоих концов |
Предпочтителен для стека или очереди. |
HashMap |
Ожидаемое O(1) по ключу |
Ожидаемое O(1) |
Ожидаемое O(1) |
Зависит от хеширования, равенства, ёмкости и распределения ключей. |
HashSet |
Ожидаемое O(1) для наличия |
Ожидаемое O(1) |
Ожидаемое O(1) |
Полезен для уникальности и проверки наличия. |
ArrayList.add() имеет амортизированное O(1): большинство добавлений постоянны по времени, но редкое расширение копирует внутренний массив за O(n). Последовательность из n добавлений всё равно стоит O(n) суммарно.
Хеш-коллекции требуют стабильных и согласованных equals() и hashCode(). Изменение участвующих в них полей объекта, пока он является ключом или элементом set, может сделать его фактически недоступным. Плохое распределение увеличивает число коллизий и ухудшает производительность.
HashMap не является потокобезопасным. Для параллельного структурного изменения нужна внешняя синхронизация или конкурентная коллекция; см. ConcurrentHashMap.
Сложность в Android-коде
Big O предсказывает масштабирование, но две реализации O(n) могут сильно отличаться из-за аллокаций, локальности кеша, boxing, I/O или работы на главном потоке. Малый ввод может не оправдывать сложный алгоритм, а линейная операция в каждом кадре всё равно способна вызвать jank.
Сначала определите реалистичный размер данных и видимую пользователю проблему. Используйте профилирование, Microbenchmark для изолированного горячего кода и Macrobenchmark для сценариев вроде запуска или прокрутки. Оптимизируйте измеренную работу, сохраняя корректность и читаемость.
Связанные темы: Коллекции, Java Core, Производительность и память и Java Concurrency.